 Proyecto ia · localcomfyui
Aleph: un estudio de IA generativa 100 % local
Un estudio multimodal que corre entero en tu ordenador: imagen, vídeo, audio para vídeo y voz en una sola página local.
- Tipo
- App local
- Dependencias
- 0
- Modelos
- ~40 GB
- VRAM
- 8 GB
- año
- 2026
Qué es Aleph
Aleph es un estudio de IA generativa que funciona por completo en local: genera imagen, vídeo, banda sonora para vídeo y voz desde una sola página web servida en 127.0.0.1, sin nube, sin cuentas y sin que ningún dato salga de la máquina. Por debajo unifica dos mundos: ComfyUI como motor de imagen y vídeo, y modelos de HuggingFace ejecutados en subprocesos propios. El nombre viene del Aleph de Borges: un punto que contiene todas las imágenes. La misma idea, aplicada a modelos de lenguaje: DRAGO Model Runner.
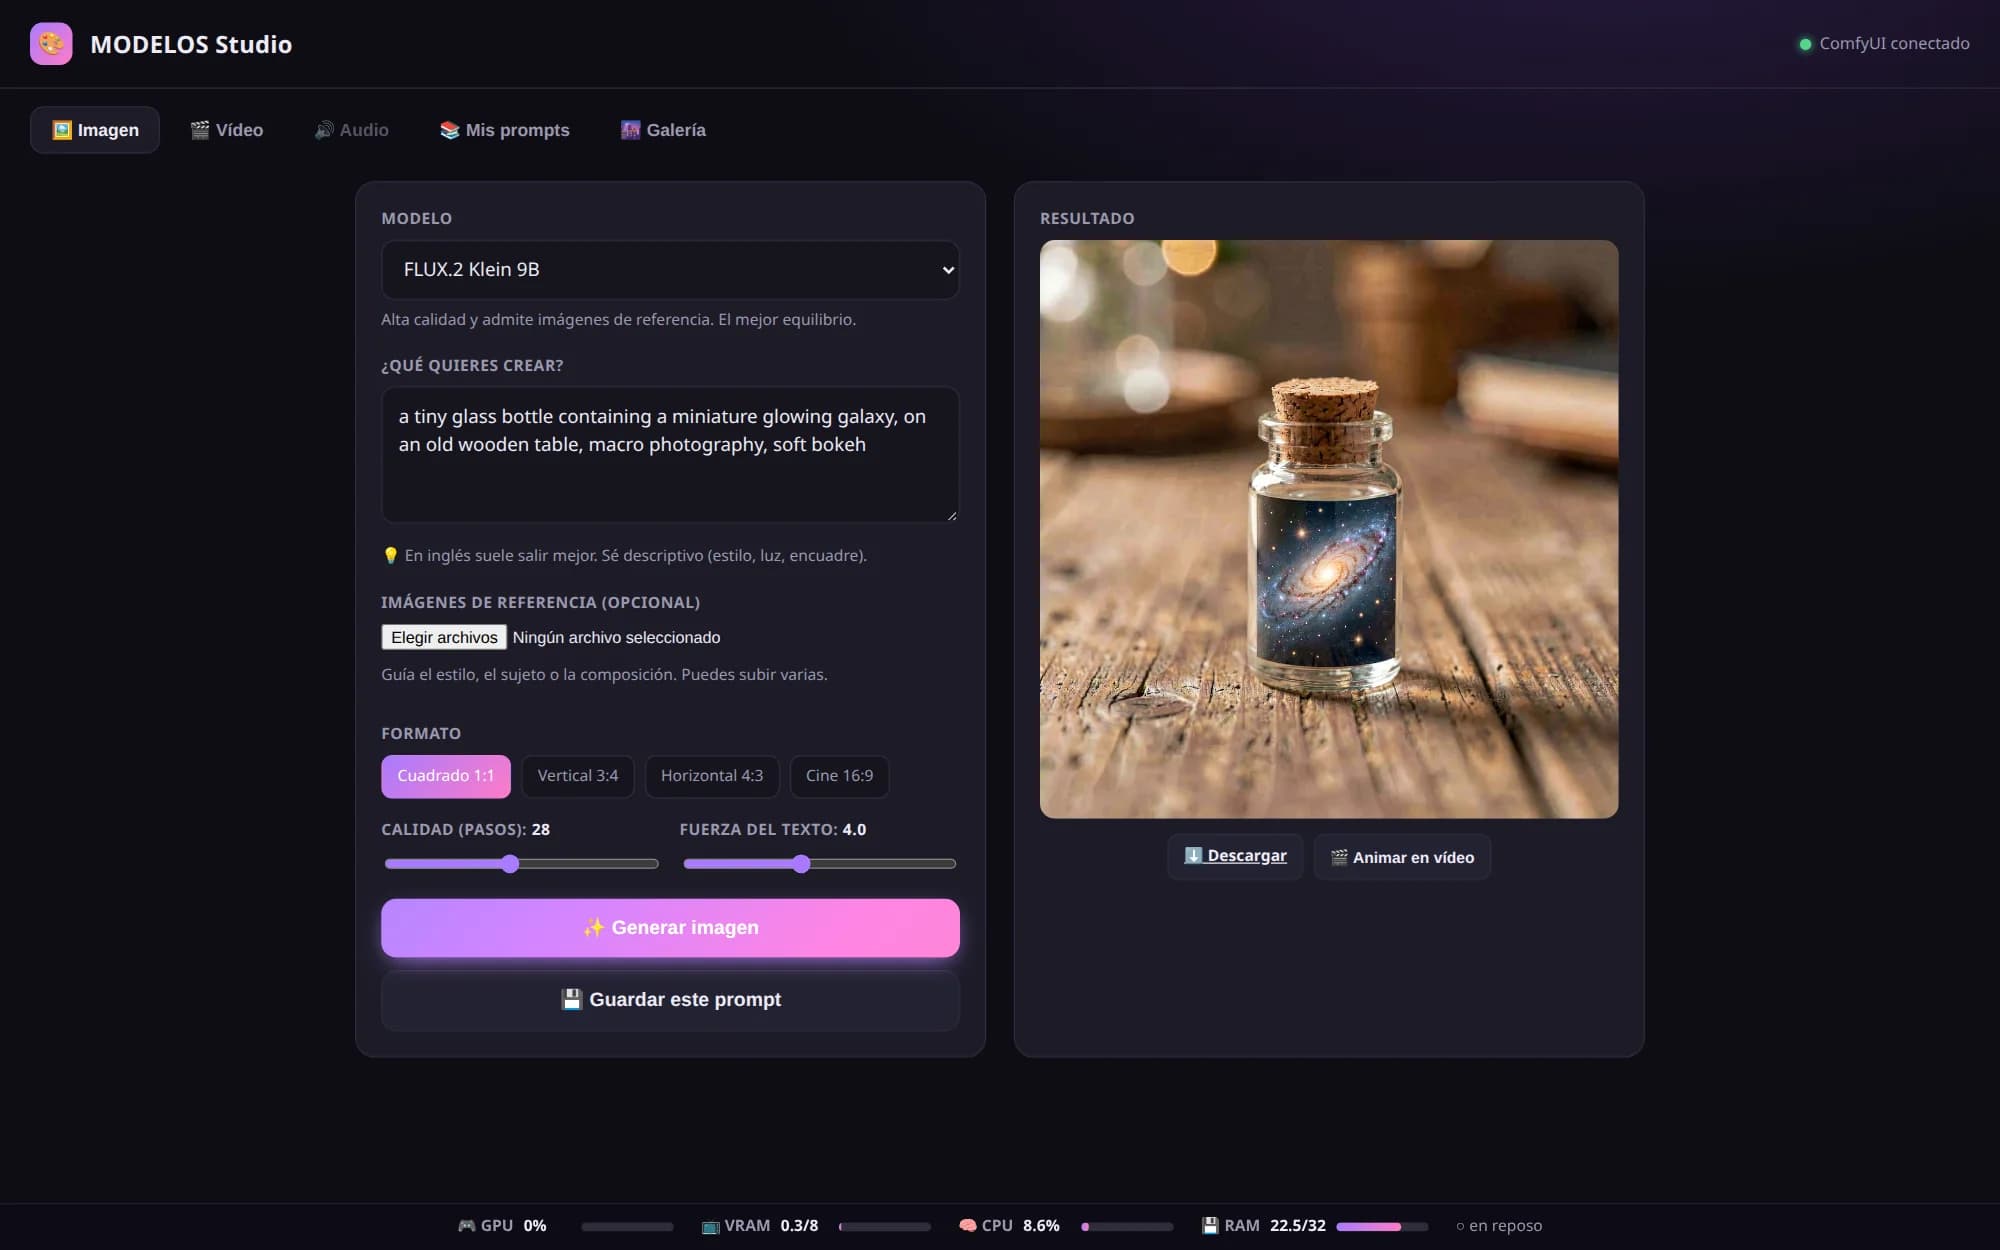
Texto a imagen
FLUX.2 Klein 9B con imágenes de referencia encadenables, o Pony Diffusion V6 XL como alternativa SDXL.
Texto e imagen a vídeo
Wan 2.2 TI2V-5B genera MP4 a 24 fps desde un prompt, o animando cualquier imagen como fotograma de partida.
Vídeo a audio
MMAudio compone una banda sonora para un vídeo subido y devuelve el vídeo recompuesto con su pista de audio.
Texto a voz
Qwen3-TTS CustomVoice con 10 idiomas, 9 voces y un campo de instrucción libre para controlar el tono.
Monitor de sistema
GPU con VRAM, temperatura y potencia; CPU con una barra por núcleo; RAM, swap y disco, refrescado cada 2 segundos.
Galería y prompts
Todas las salidas en una rejilla unificada, con biblioteca de prompts reutilizables y encadenado de imagen a vídeo en un clic.
Capturas reales (versión MODELOS Studio: imagen y vídeo, sin voz)
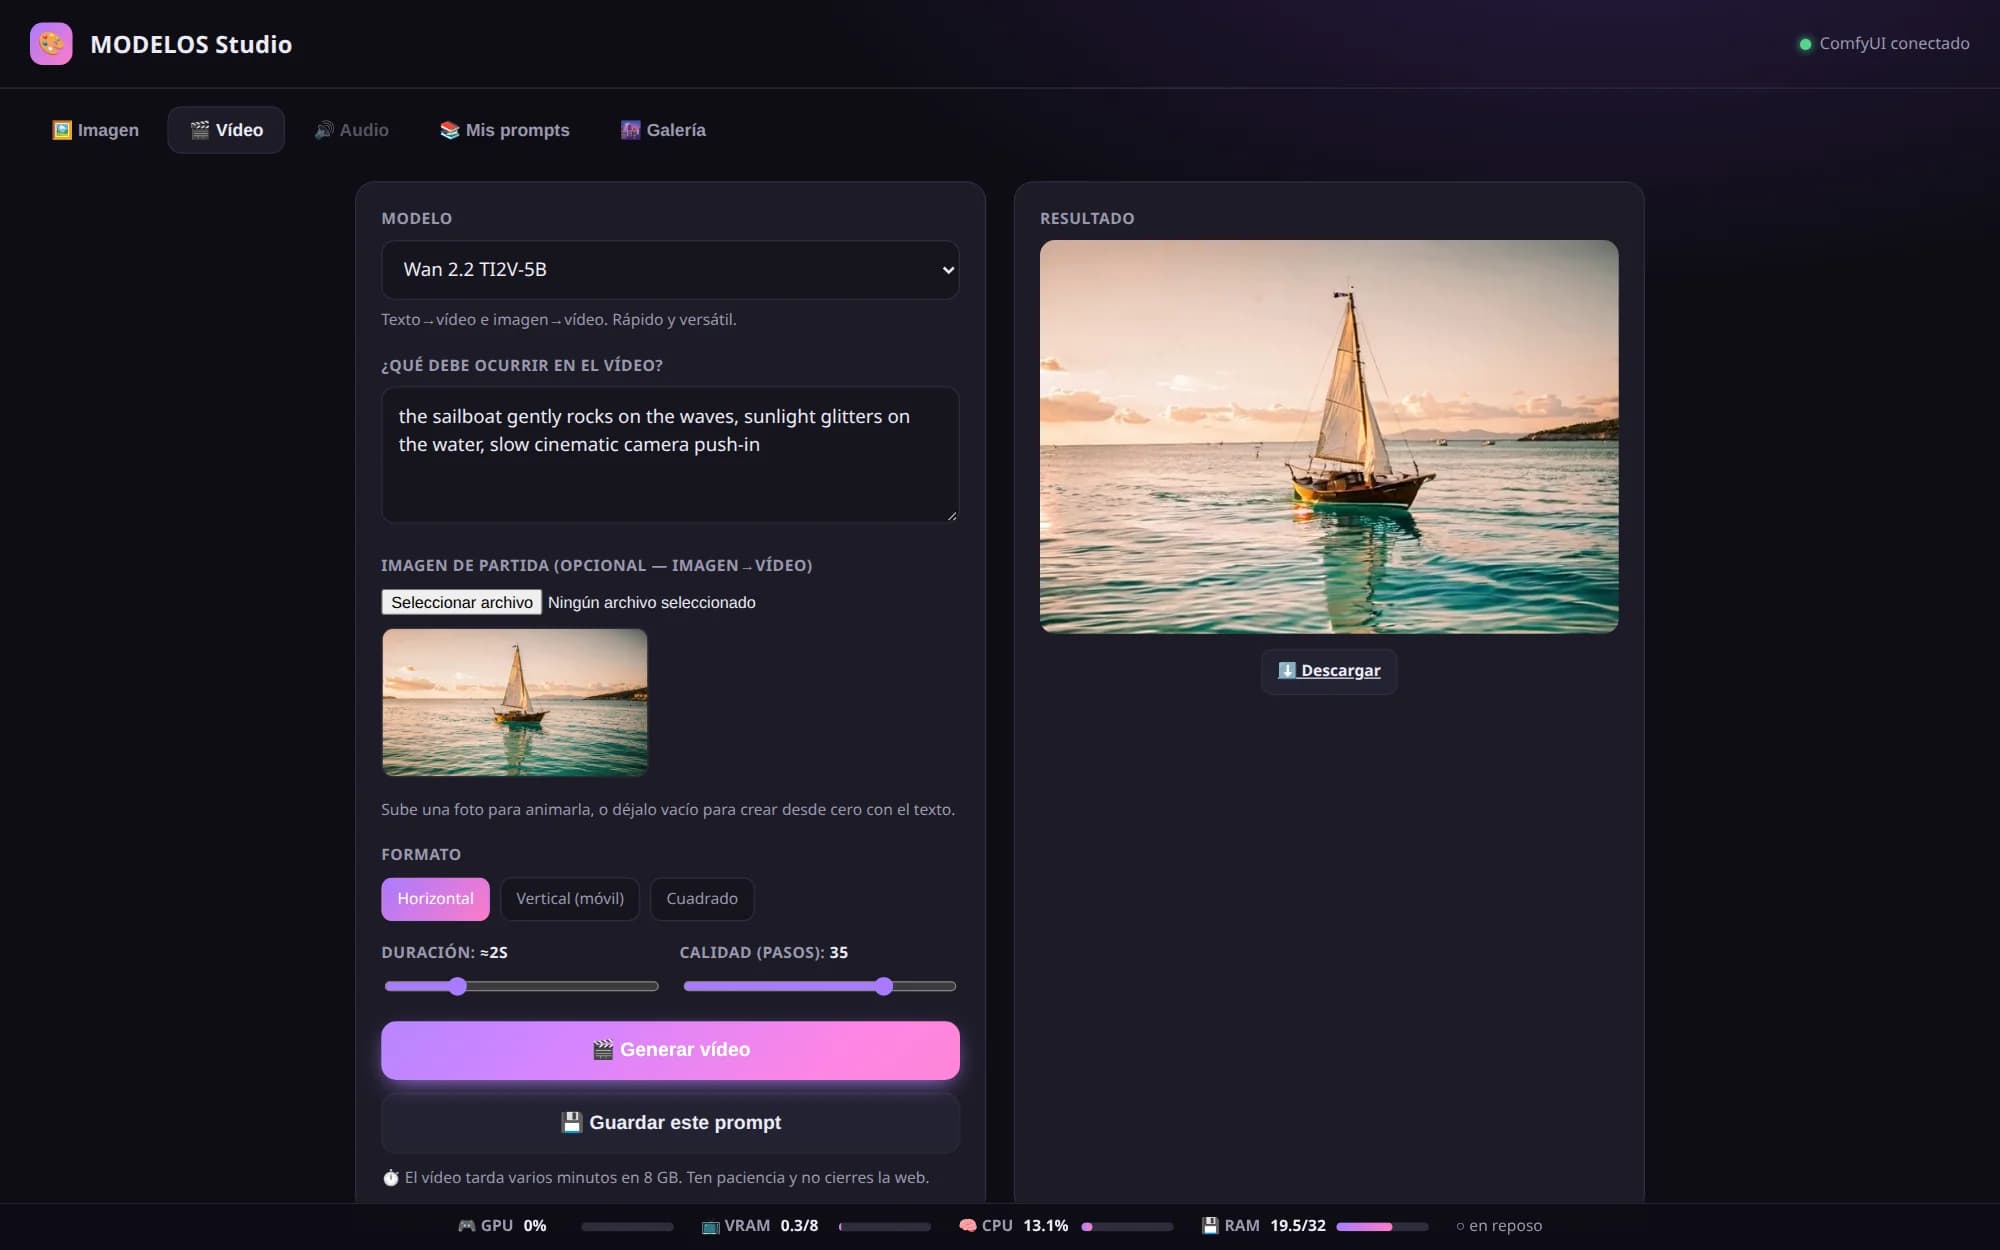
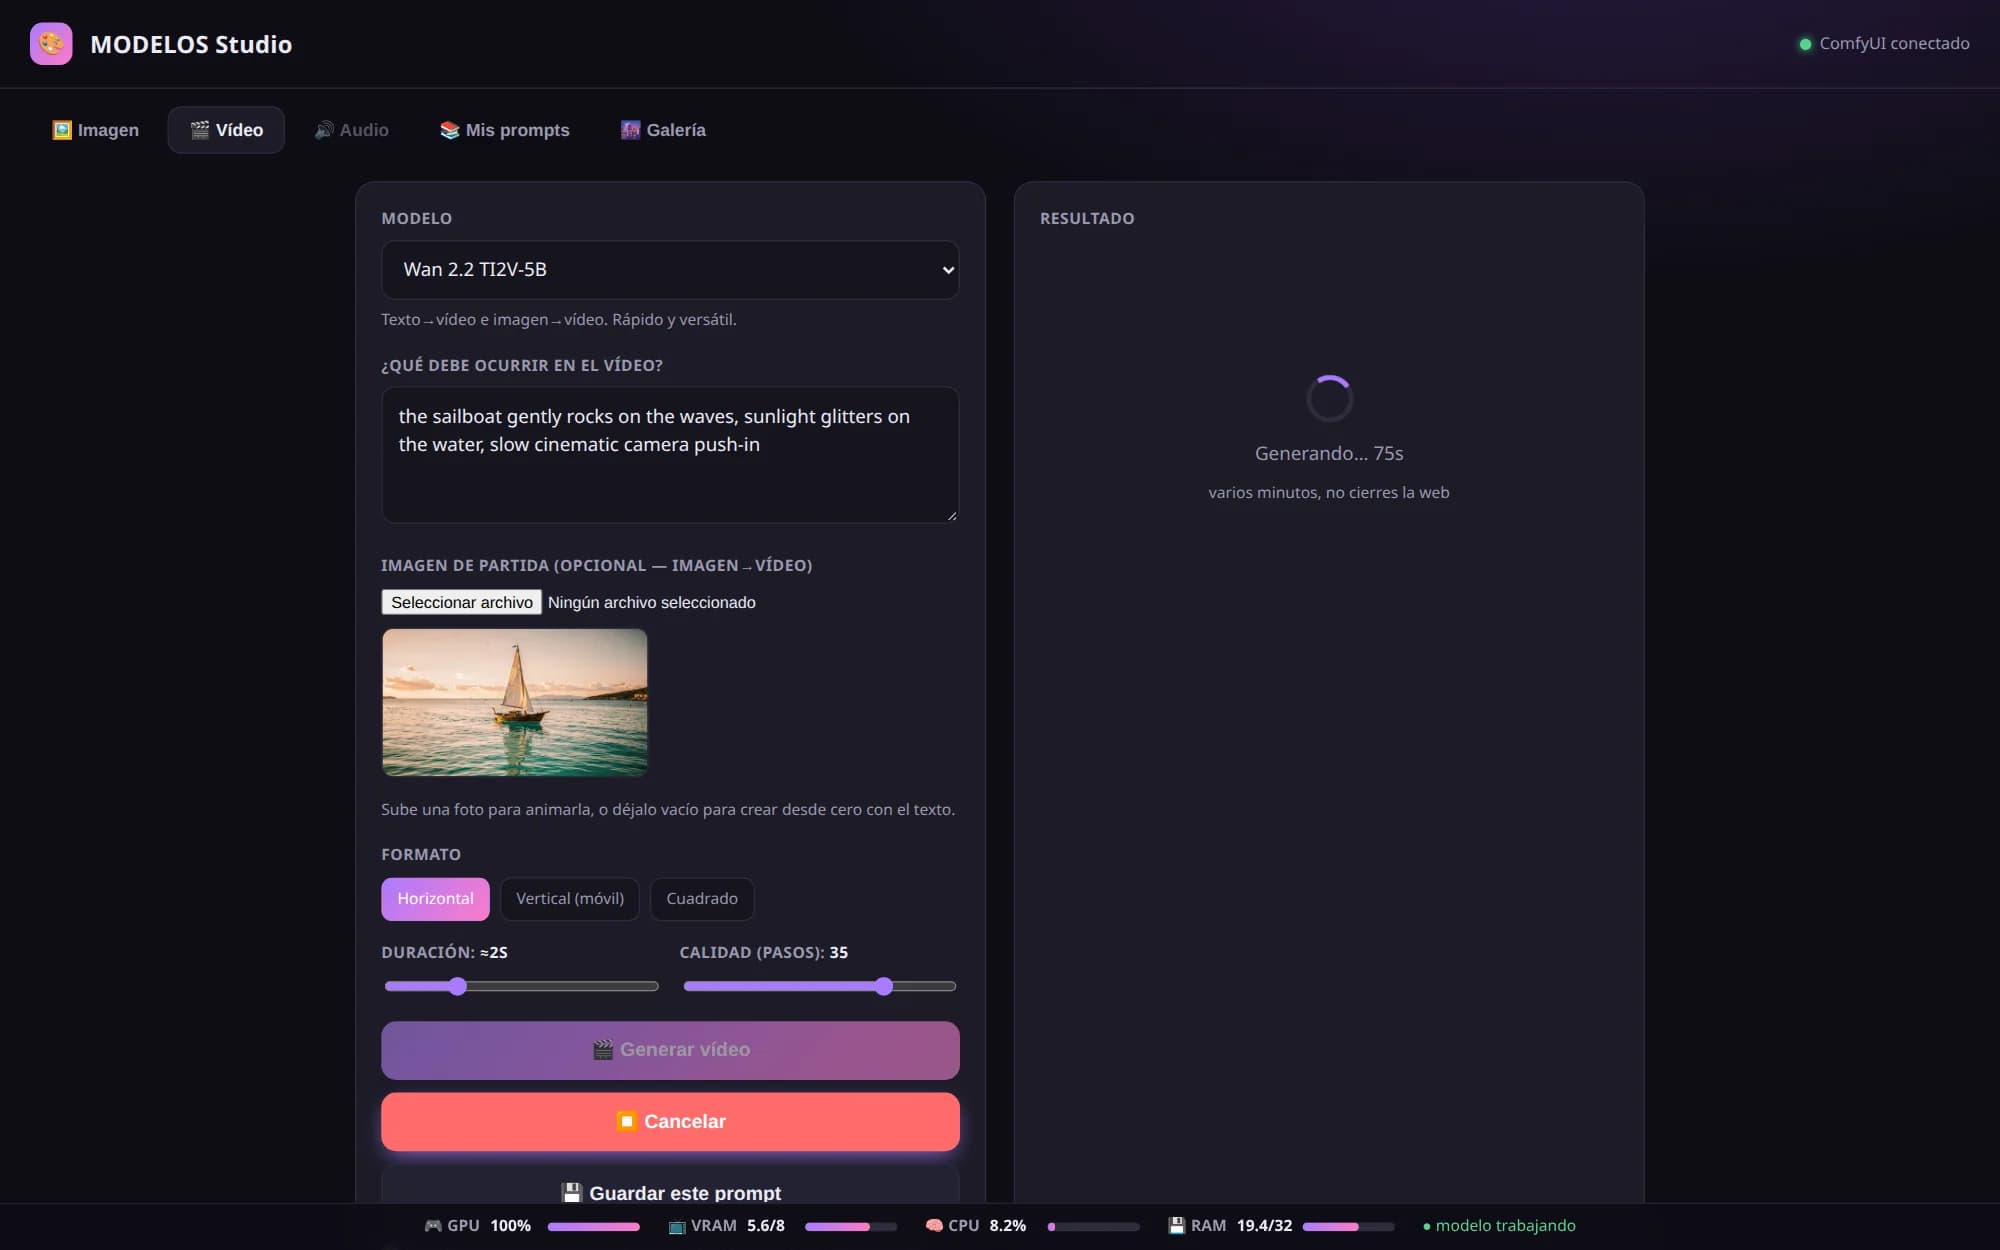
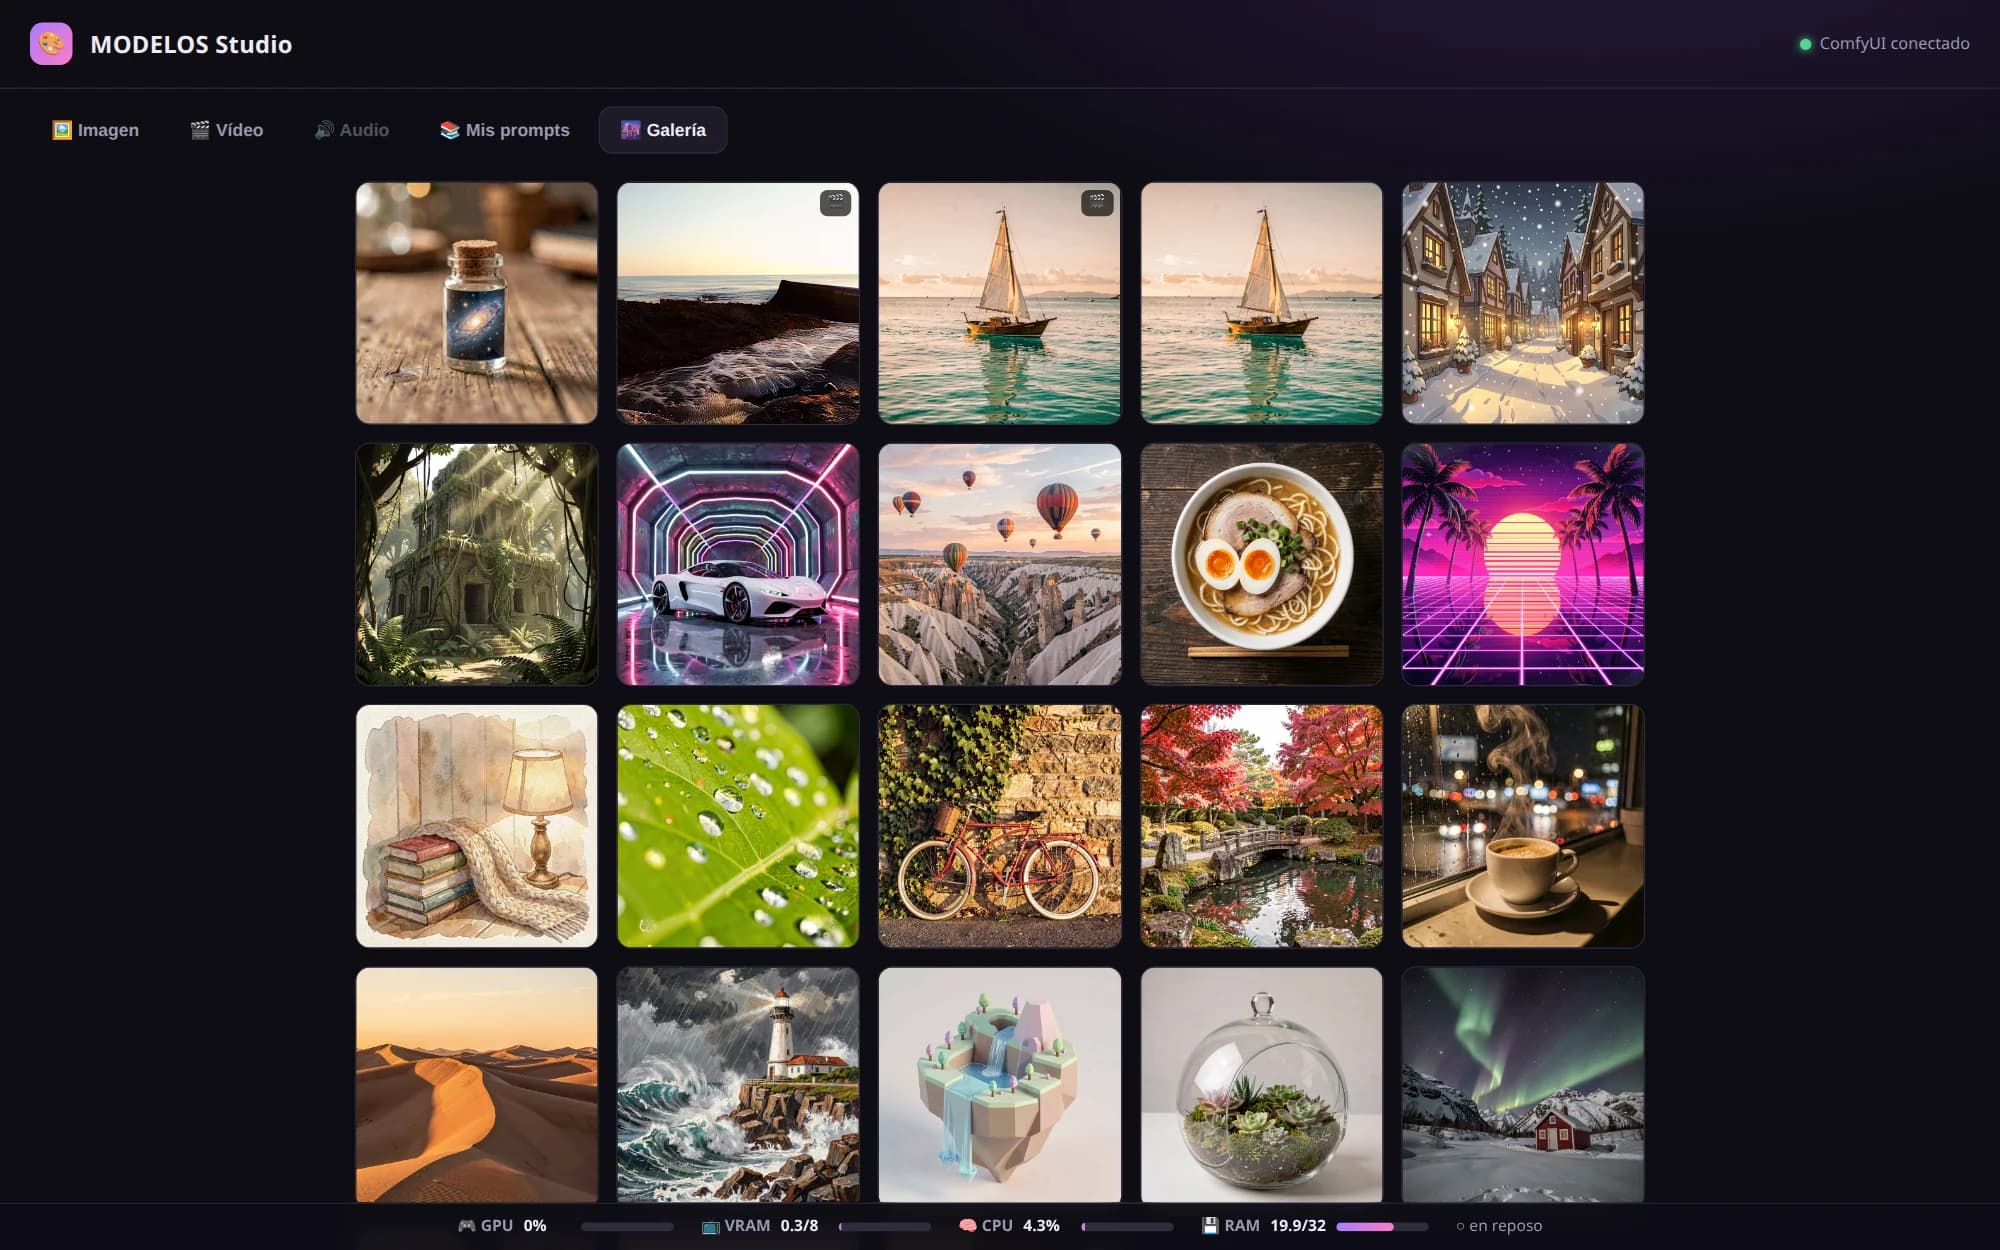
Voz generada en local con Qwen3-TTS
Flujo de una generación
- Elegir una capacidad en la barra lateral; solo aparecen las que tienen sus modelos en disco.
- Rellenar el formulario, que se genera solo a partir del catálogo declarativo.
- Lanzar el trabajo; el navegador sondea su estado cada 2 segundos con cancelación real.
- Ver el resultado en el panel derecho y en la galería, listo para descargar o animar en vídeo.
Un servidor sin una sola dependencia
El backend web usa exclusivamente la librería estándar de Python: ni Flask, ni FastAPI, ni siquiera requests. Hasta el parseo de formularios multipart está escrito a mano en veinte líneas. No es purismo: al no importar torch en el proceso del servidor, arrancar Aleph es trivial y liberar memoria gráfica es tan fiable como matar un subproceso. La app pesa menos de 350 KB de código propio frente a los ~40 GB de modelos que orquesta.
Cómo caben los modelos en 8 GB
Nada de esto cabría en una GPU de portátil con los pesos originales. Los modelos grandes van cuantizados: FLUX.2 Klein 9B y Wan 2.2 en GGUF Q6_K, el codificador de texto de FLUX (Qwen3 8B) en fp8 y el de Wan (UMT5-XXL) en GGUF Q5_K_M. ComfyUI arranca con --lowvram, que reparte los modelos entre la VRAM y la RAM del sistema. El precio se paga en tiempo: la primera generación de cada sesión es lenta porque carga los pesos, y un segundo de vídeo a 704×480 cuesta alrededor de minuto y medio.
No todo cupo. SCAIL-2, un modelo de animación de personajes por pose, se descartó tras investigarlo: sus pesos publicados son un checkpoint de entrenamiento de 65,6 GB sin versión cuantizada, inviable en 8 GB.
Una interfaz que se dibuja sola
El frontend no tiene ni un formulario escrito a mano: cada capacidad se declara como datos en un catálogo (categoría, motor, campos con su tipo) y la web lo convierte en interfaz con ocho tipos de campo. Añadir un modelo nuevo no toca ni una línea de HTML. Los campos pueden depender del modelo elegido: las imágenes de referencia solo aparecen si el modelo activo las admite.
El panel de sistema
Generar en local con 8 GB de VRAM significa vivir pendiente del hardware, así que Aleph lo enseña todo: uso y temperatura de la GPU, potencia en vatios, VRAM, veinte barras de CPU (una por núcleo), memoria y disco, más una tarjeta con lo que está trabajando en cada momento. Todo leído directamente del sistema, sin agentes externos, y siempre visible en una barra compacta inferior.
Galería y encadenado
Las salidas de todos los motores acaban en una galería única, clasificadas por tipo y ordenadas por fecha, con los vídeos reproduciéndose al pasar el ratón. Cualquier imagen —recién generada o antigua— tiene un botón de animar en vídeo que la recoloca como fotograma de partida de Wan 2.2, sin pasos intermedios.
La prueba que salió mal
El diseño más ambicioso de Aleph era un segador de VRAM: matar automáticamente los subprocesos de modelo tras 90 segundos de inactividad para devolver la memoria a ComfyUI. El código existe y parece correcto, pero la única prueba conservada dice otra cosa: la VRAM se quedó en ~4,5 GB y no bajó ni pasados 37 minutos. Se guardó el resultado fallido tal cual, y ahí sigue.
“Hecho para funcionar en local, para ti. Tus datos, tus modelos y tus creaciones no salen de tu ordenador.”
Estado real
Aleph se escribió en una tarde de julio de 2026 y quedó terminado como versión 1: unas 3.800 líneas propias, 4 capacidades, 5 modelos y 12 rutas de API, verificado con salidas reales de voz e imagen. También tiene deudas claras: no hay barra de progreso real para imagen y vídeo (solo un cronómetro), la semilla no es controlable desde la interfaz —no se puede repetir una generación buena—, no hay tests y solo funciona en Linux con GPU NVIDIA.
La versión publicada en el repositorio referencia los pesos por ruta absoluta, una decisión deliberada que se rompe si el directorio de modelos cambia de nombre; hacerla configurable con una variable de entorno es el siguiente arreglo.
Ámbito
Aleph escucha solo en 127.0.0.1 y no tiene autenticación: está pensado para un solo usuario en su propia máquina, no para exponerse a la red. Requiere Linux y GPU NVIDIA.
Materiales / Compra
Tienda: Motor de imagen y vídeo: ComfyUI con los modelos FLUX.2 Klein 9B, Pony Diffusion V6 XL, Wan 2.2 TI2V-5B y MMAudio 44k. Voz: Qwen3-TTS 12Hz 1.7B CustomVoice de HuggingFace. Hardware de referencia: un portátil con RTX 5060 de 8 GB de VRAM.
Aprendizajes
La lección central: con 8 GB de VRAM y dos motores compitiendo, la arquitectura la dicta la memoria. Separar el servidor (sin torch, solo librería estándar) de los modelos (subprocesos matables) hizo el sistema simple y robusto; y la parte que falló —la liberación automática de VRAM— quedó documentada con su prueba, porque un resultado negativo guardado vale más que una promesa.
Publicaciones relacionadas
DRAGO Model Runner
GUI de escritorio estilo Matrix para chatear con LLMs locales vía Ollama y crearlos desde GGUF.
VIGÍA: teledetección municipal contra la obra no declarada
Compara ortofotos, cruza con el Catastro y prepara expedientes de obra no declarada.
HORUS EYE
Torreta DIY que sigue personas con visión artificial y las disuade con foco, láser y bocina.
Comentarios
0 comentarios