 Proyecto python · desktopai
DRAGO Model Runner
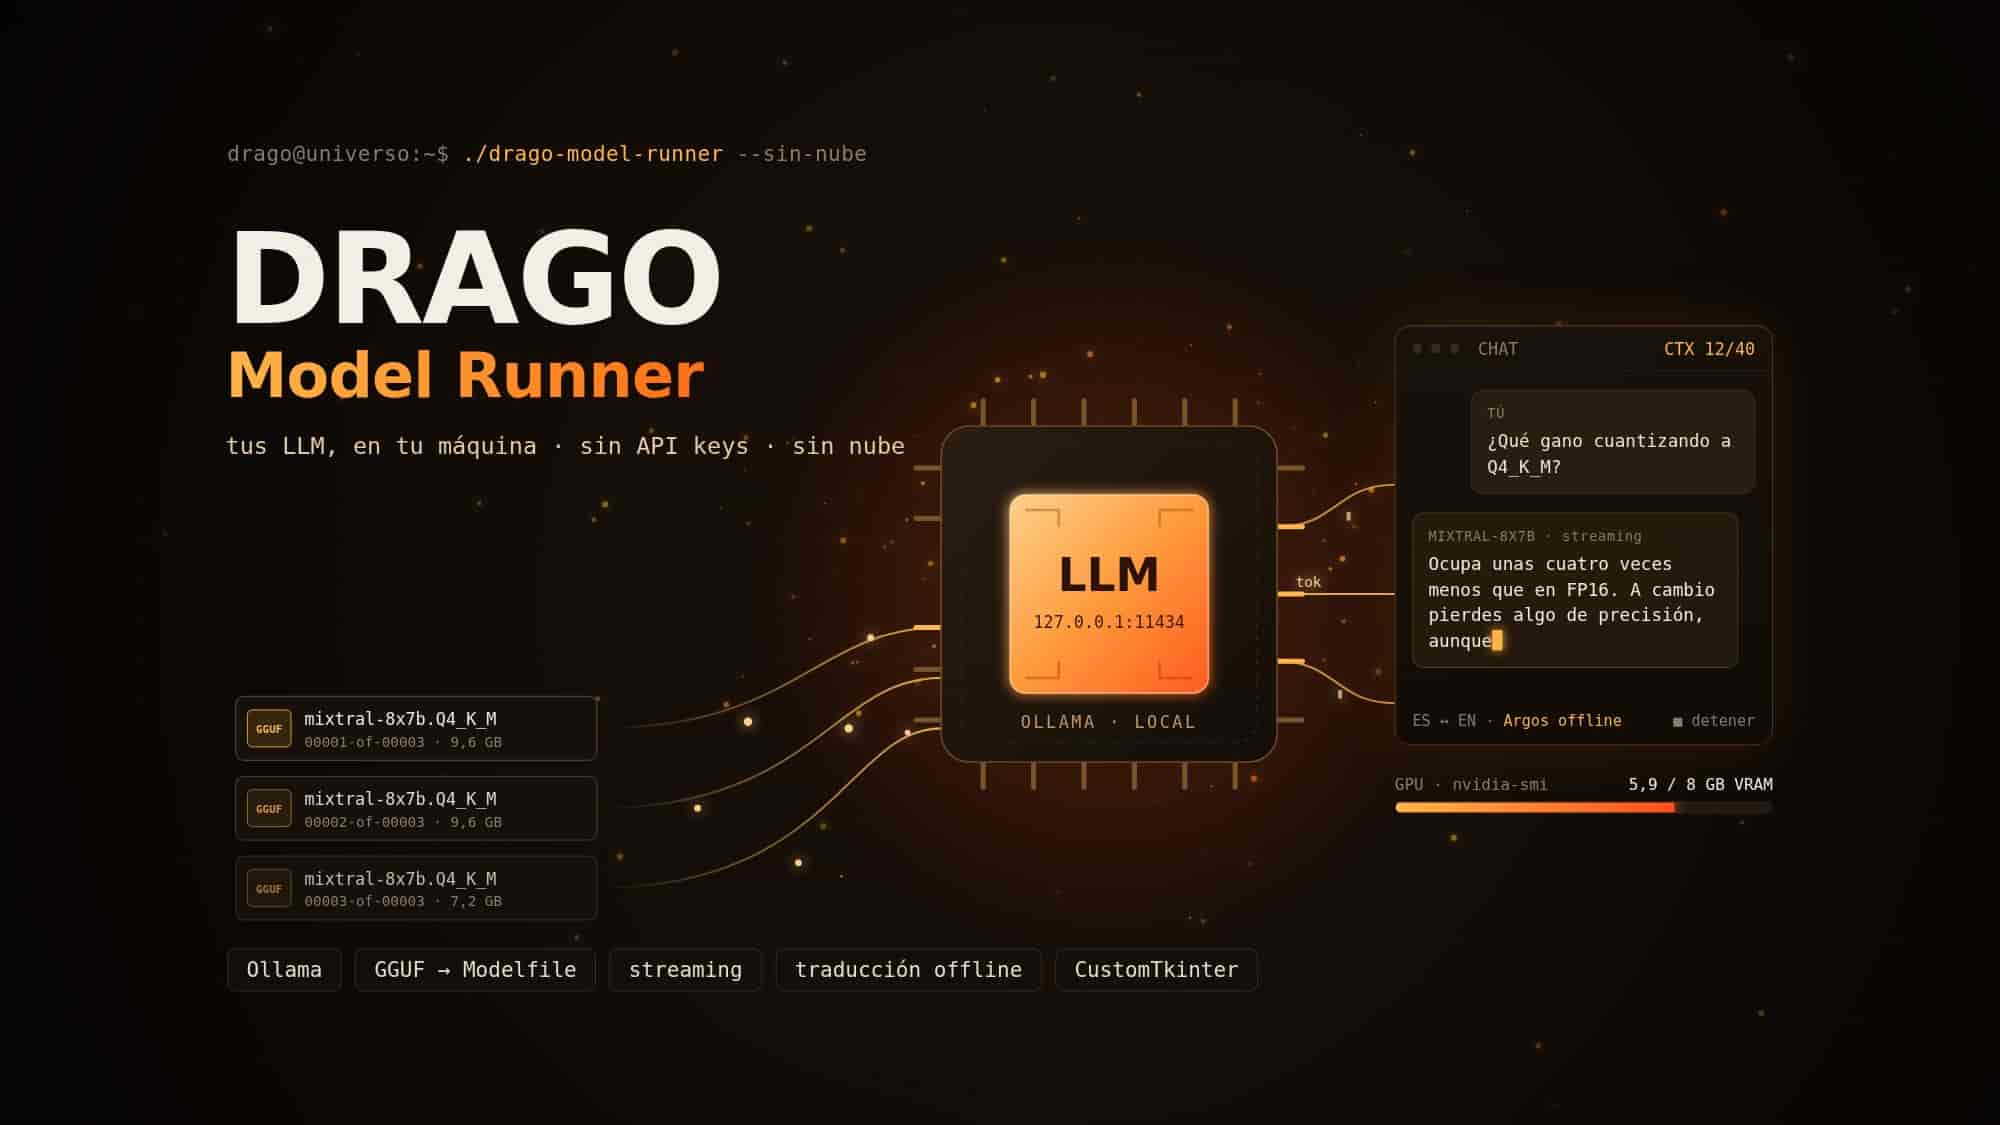
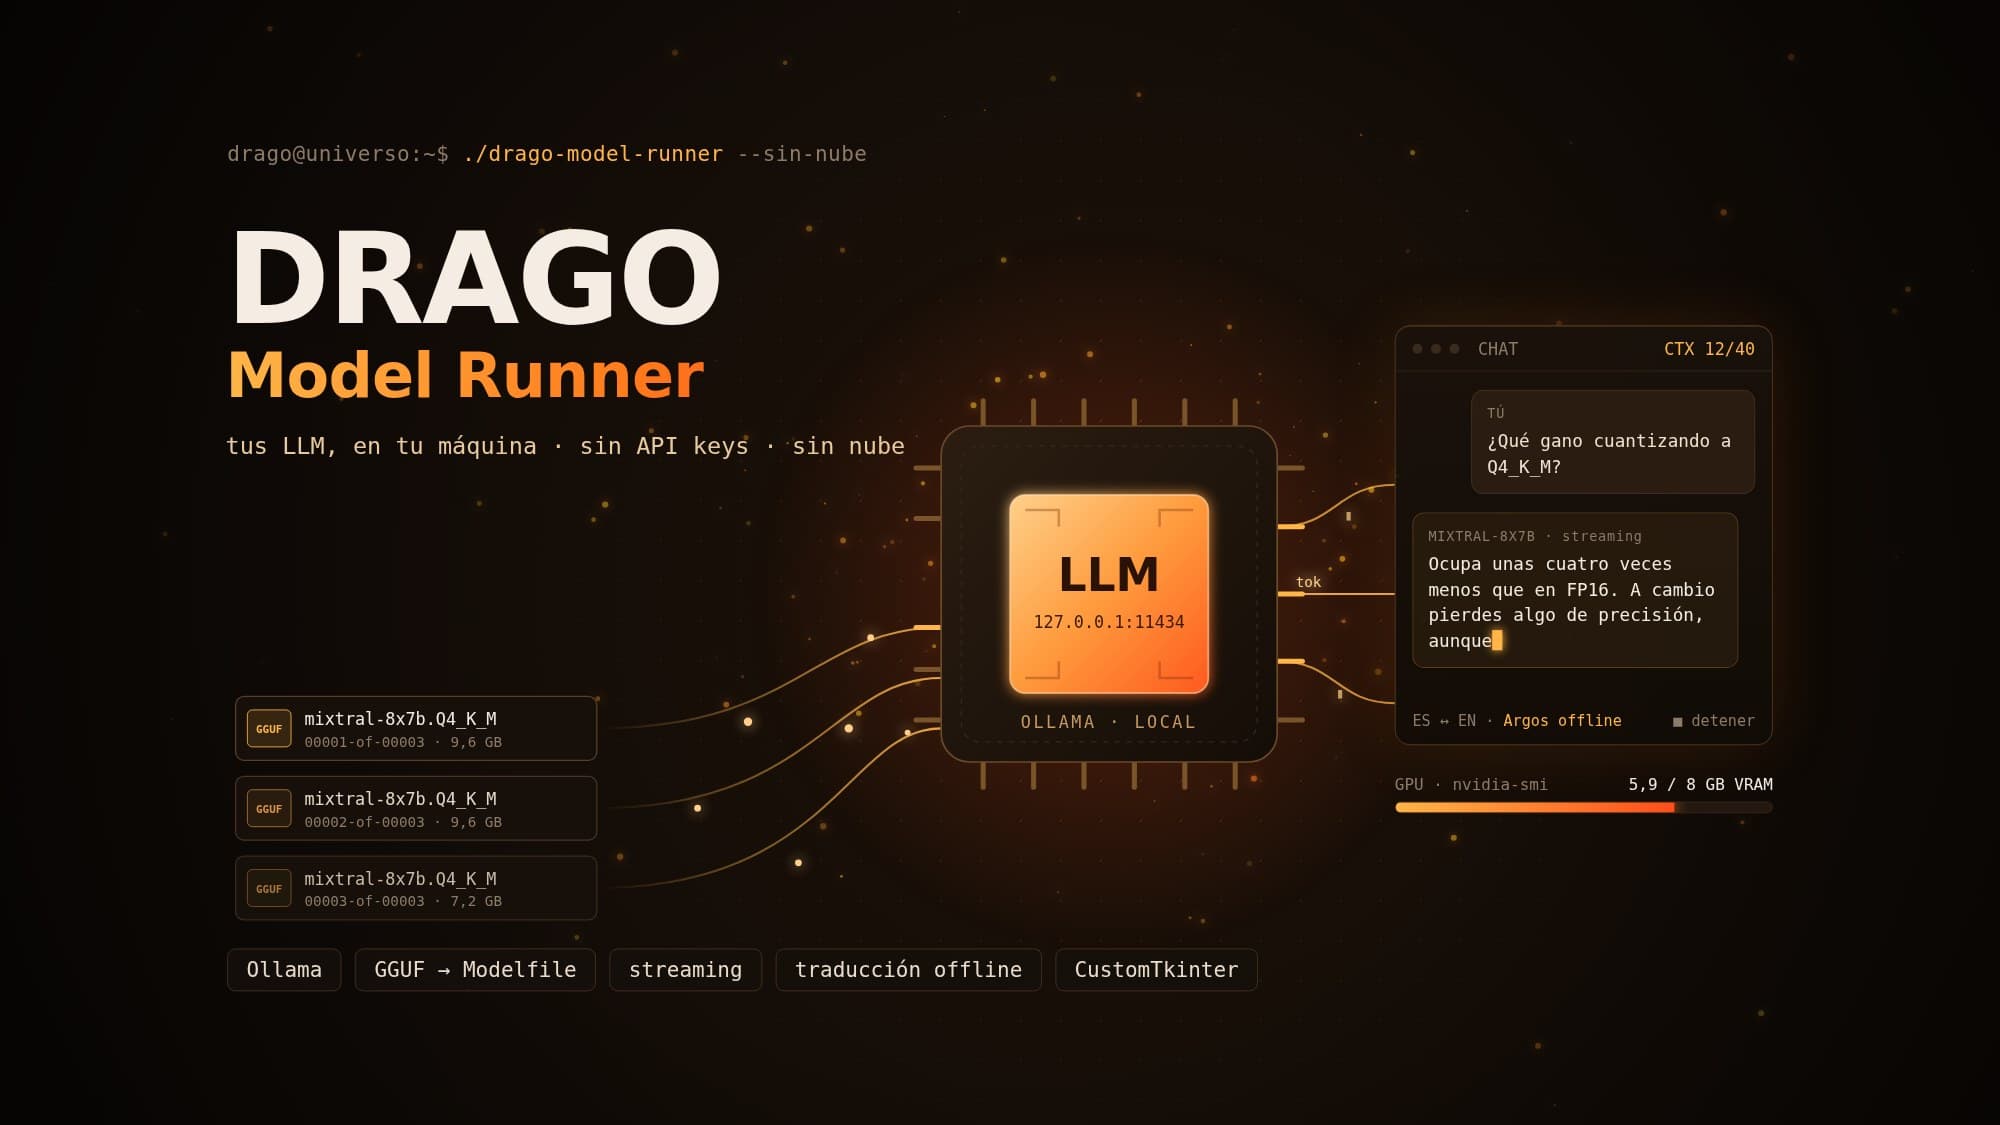
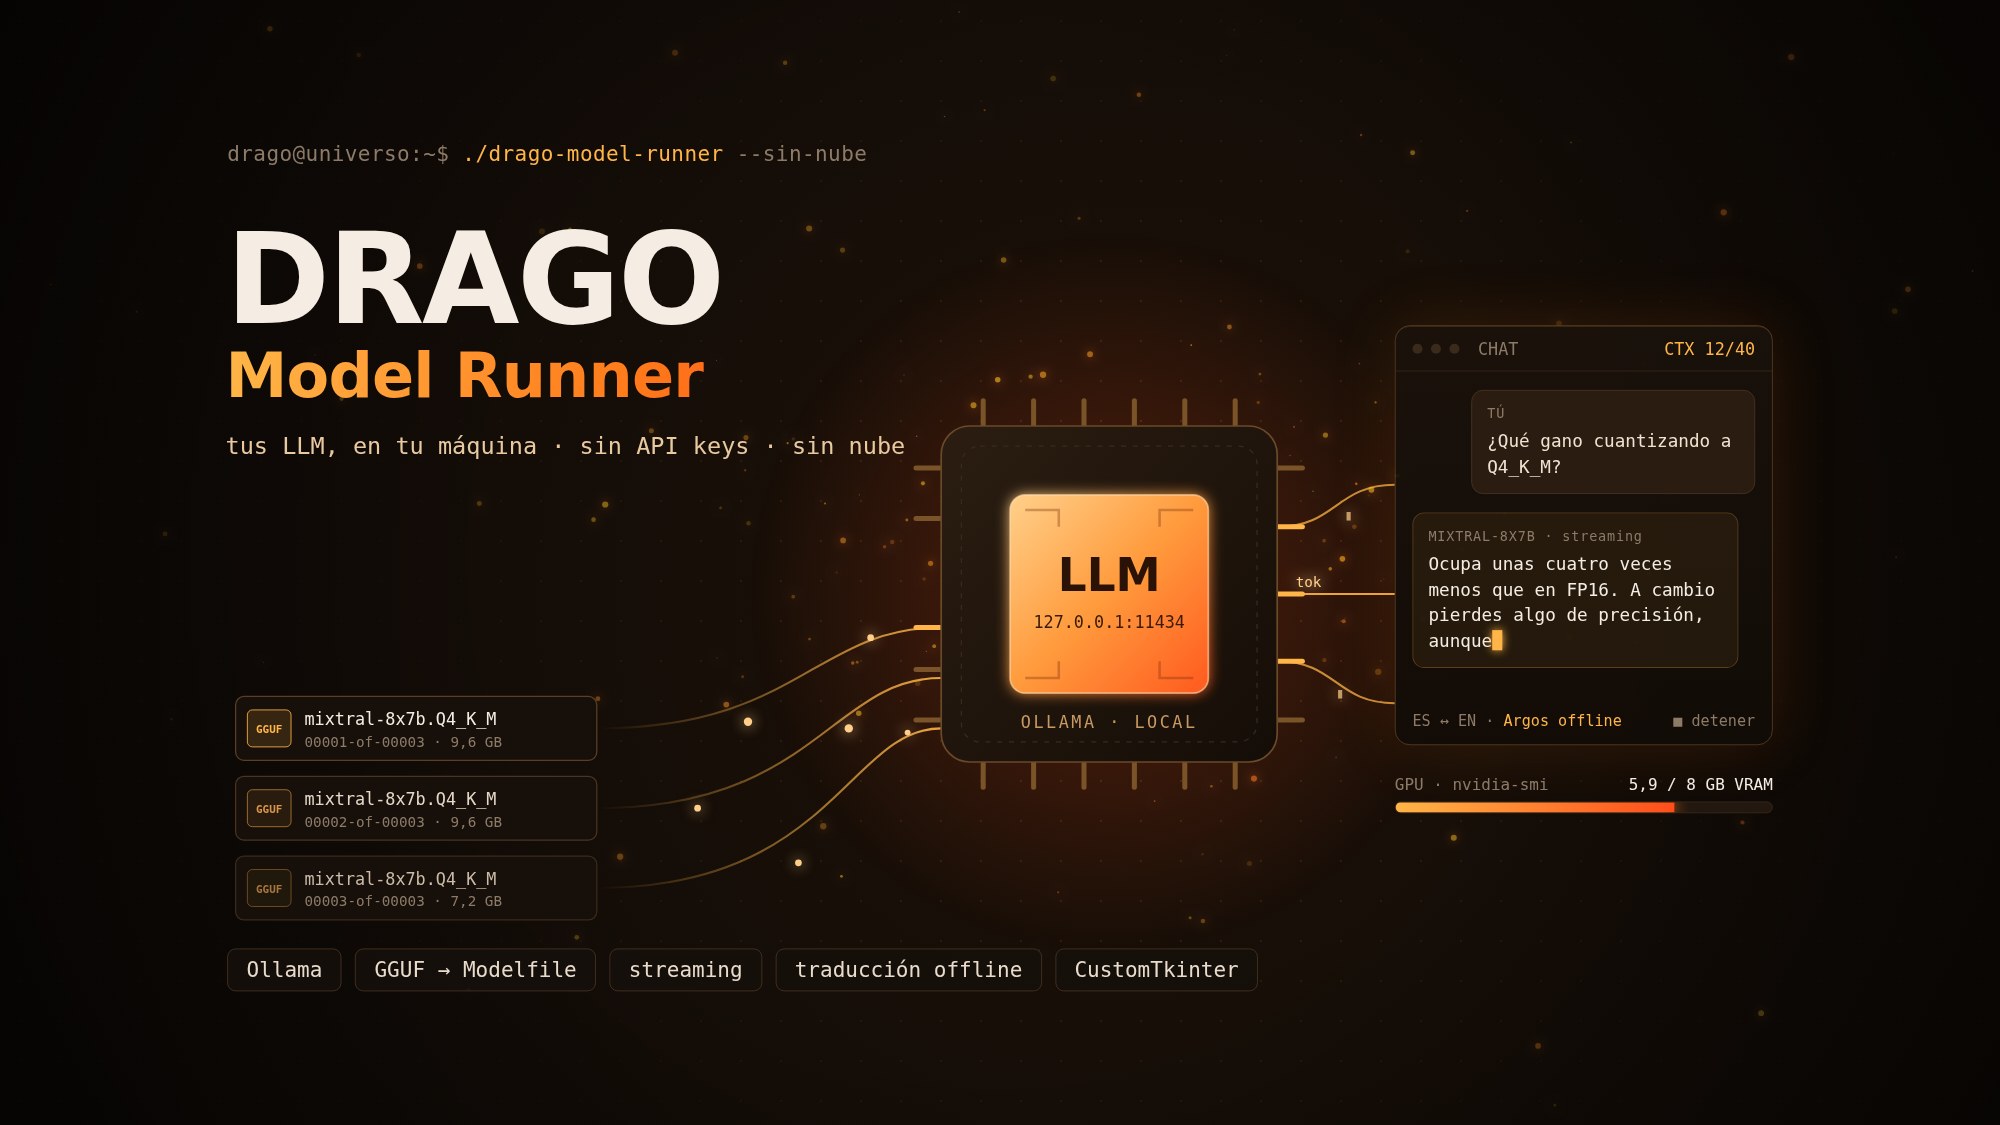
Interfaz de escritorio con estética Matrix para ejecutar modelos de lenguaje en local con Ollama: chat en streaming, creación de modelos desde GGUF, traducción offline y diagnóstico de GPU.
- Paneles
- 5
- Código
- ~9,1k líneas
- Commits
- 42
- Versión
- 1.0
- año
- 2026
- estado
- Online
Qué es DRAGO Model Runner
DRAGO Model Runner es una aplicación de escritorio en Python para usar modelos de lenguaje en tu propio ordenador, sin API keys ni nube. El motor es Ollama; la aplicación pone encima una interfaz nativa con CustomTkinter repartida en cinco paneles: Chat, Model Forge, Sistema, Ayuda y Configuración. El código es público en GitHub.
Después de usar Ollama por terminal quise algo rápido, nativo y que no dependiera del navegador. Guarda el historial de chats en ficheros JSON y traduce sin conexión para poder hablar en español con modelos que rinden mejor en inglés. La misma filosofía llevada a imagen, vídeo y voz: Aleph.
La aplicación
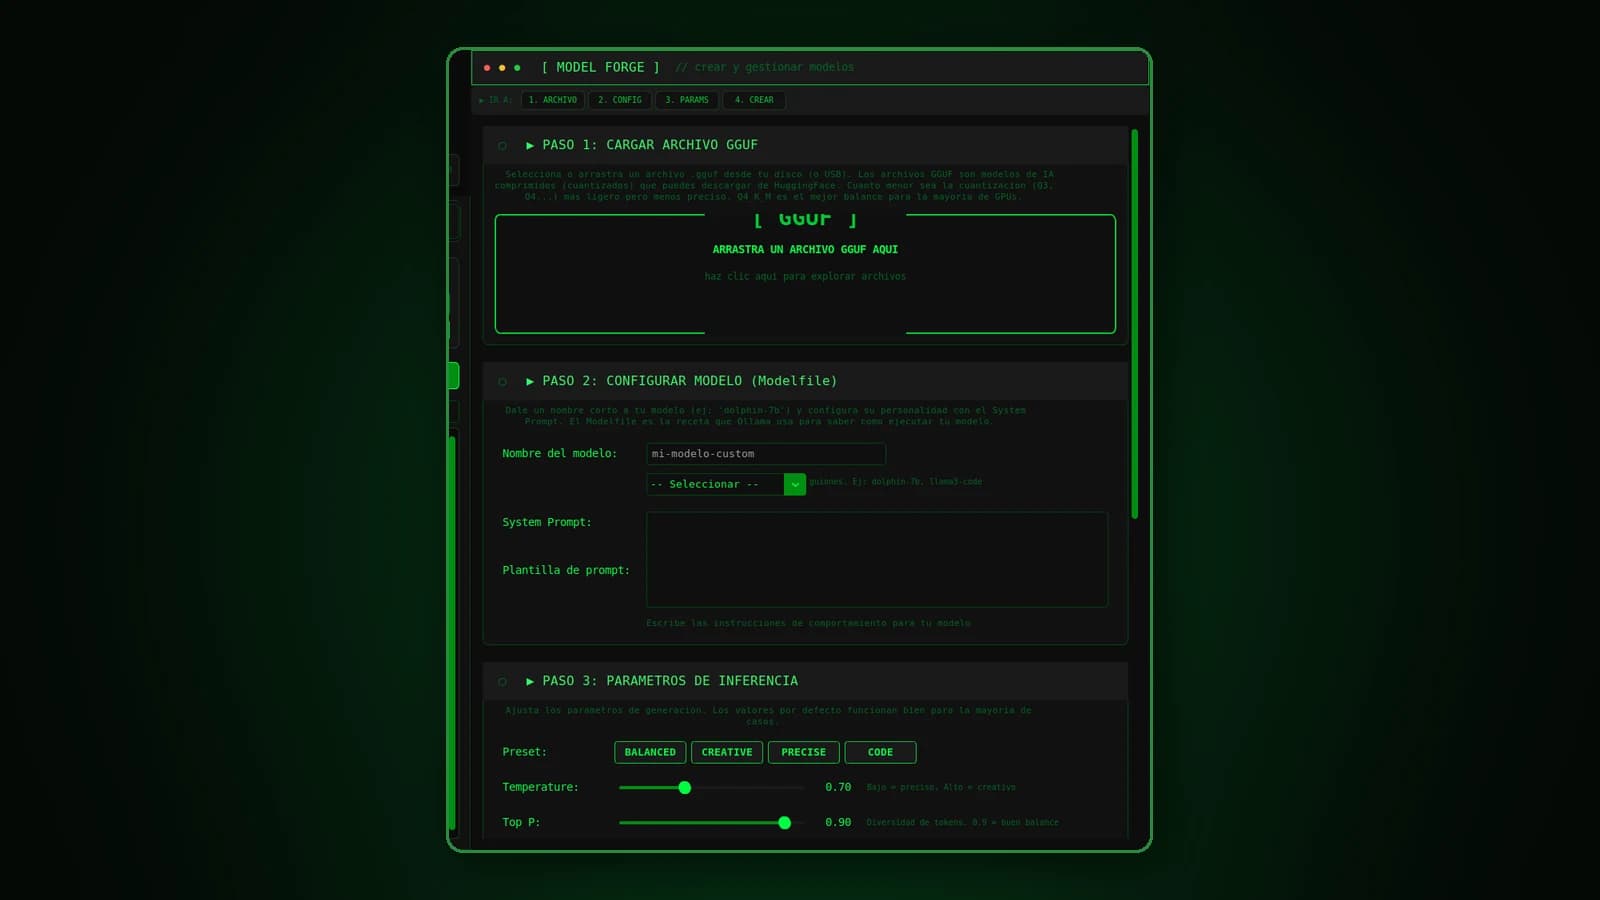
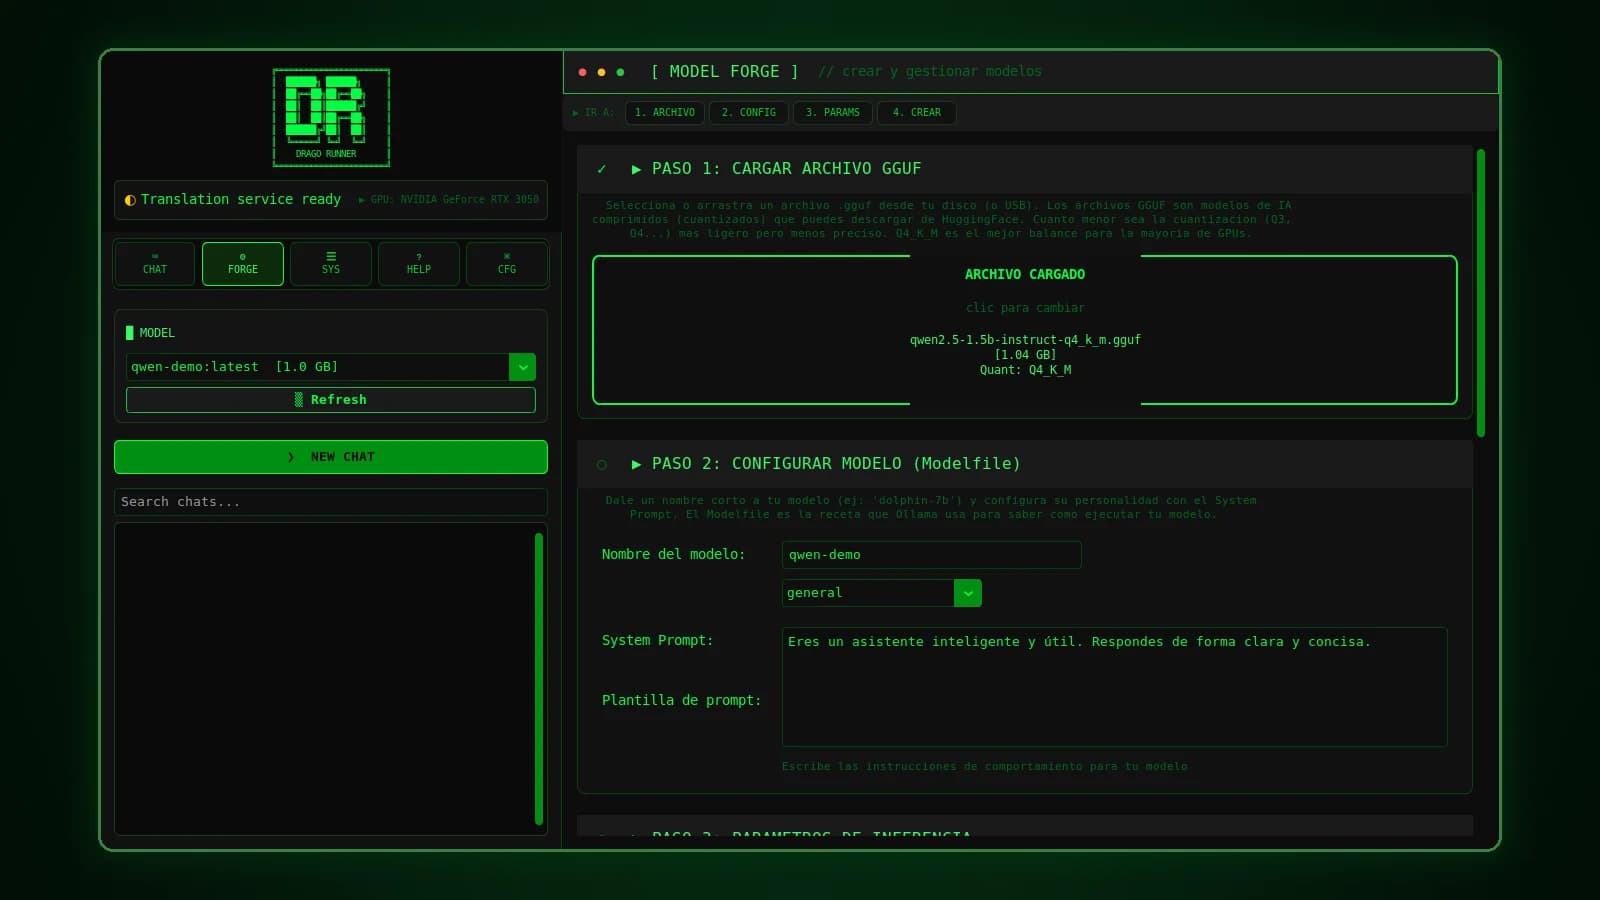
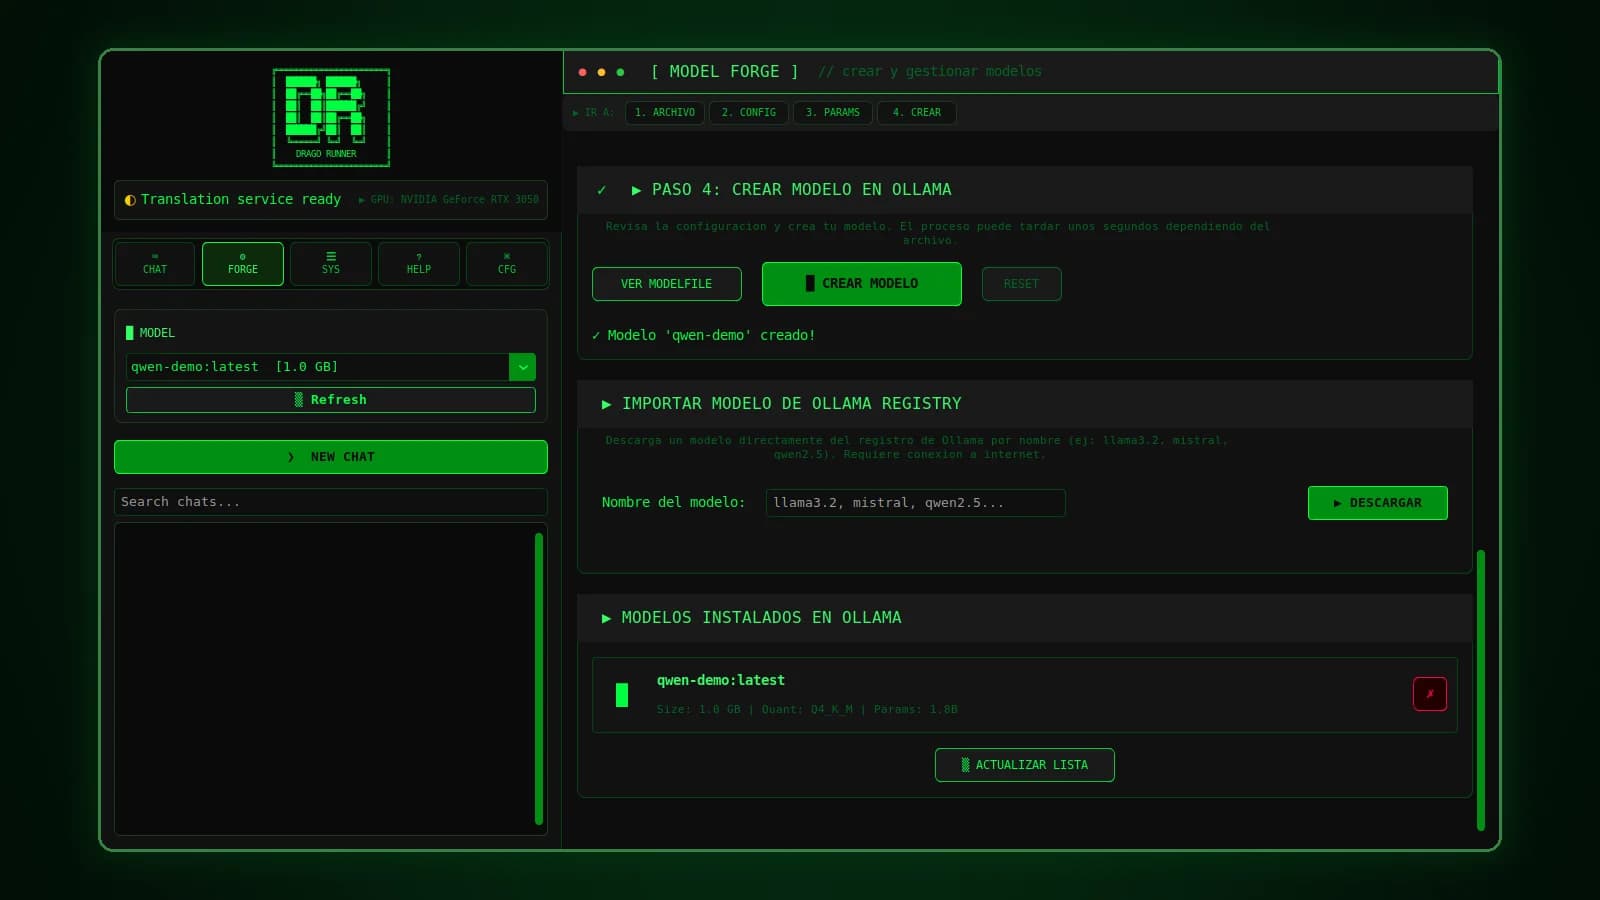
Model Forge: crear un modelo de Ollama desde un GGUF en cuatro pasos
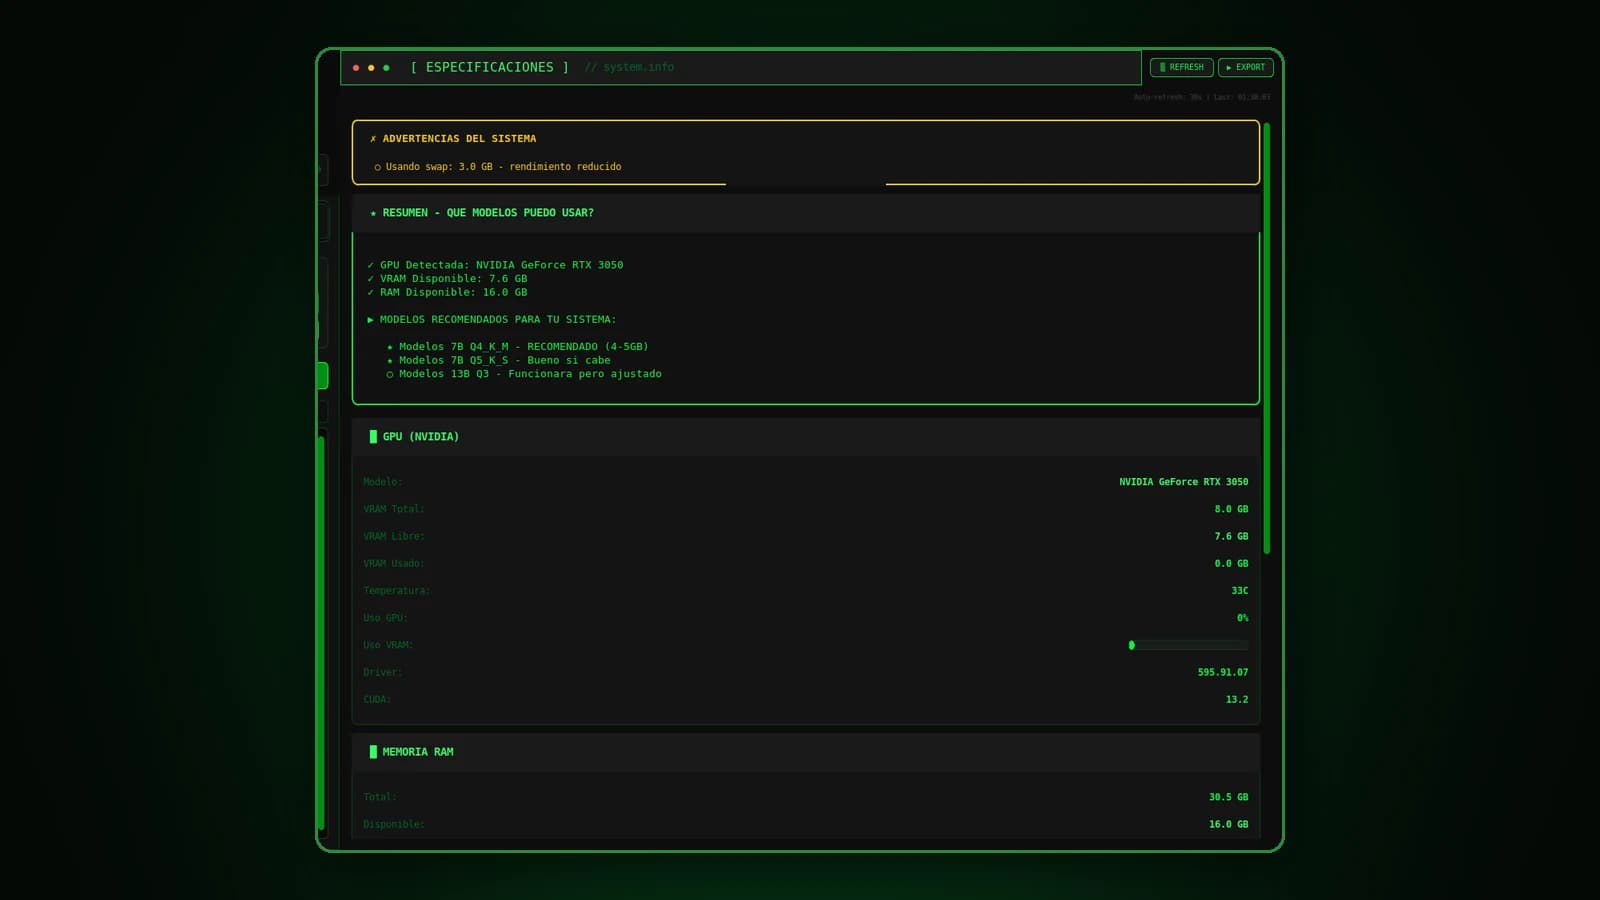
Panel Sistema: GPU, VRAM y RAM detectadas y qué modelos caben
Chat en streaming
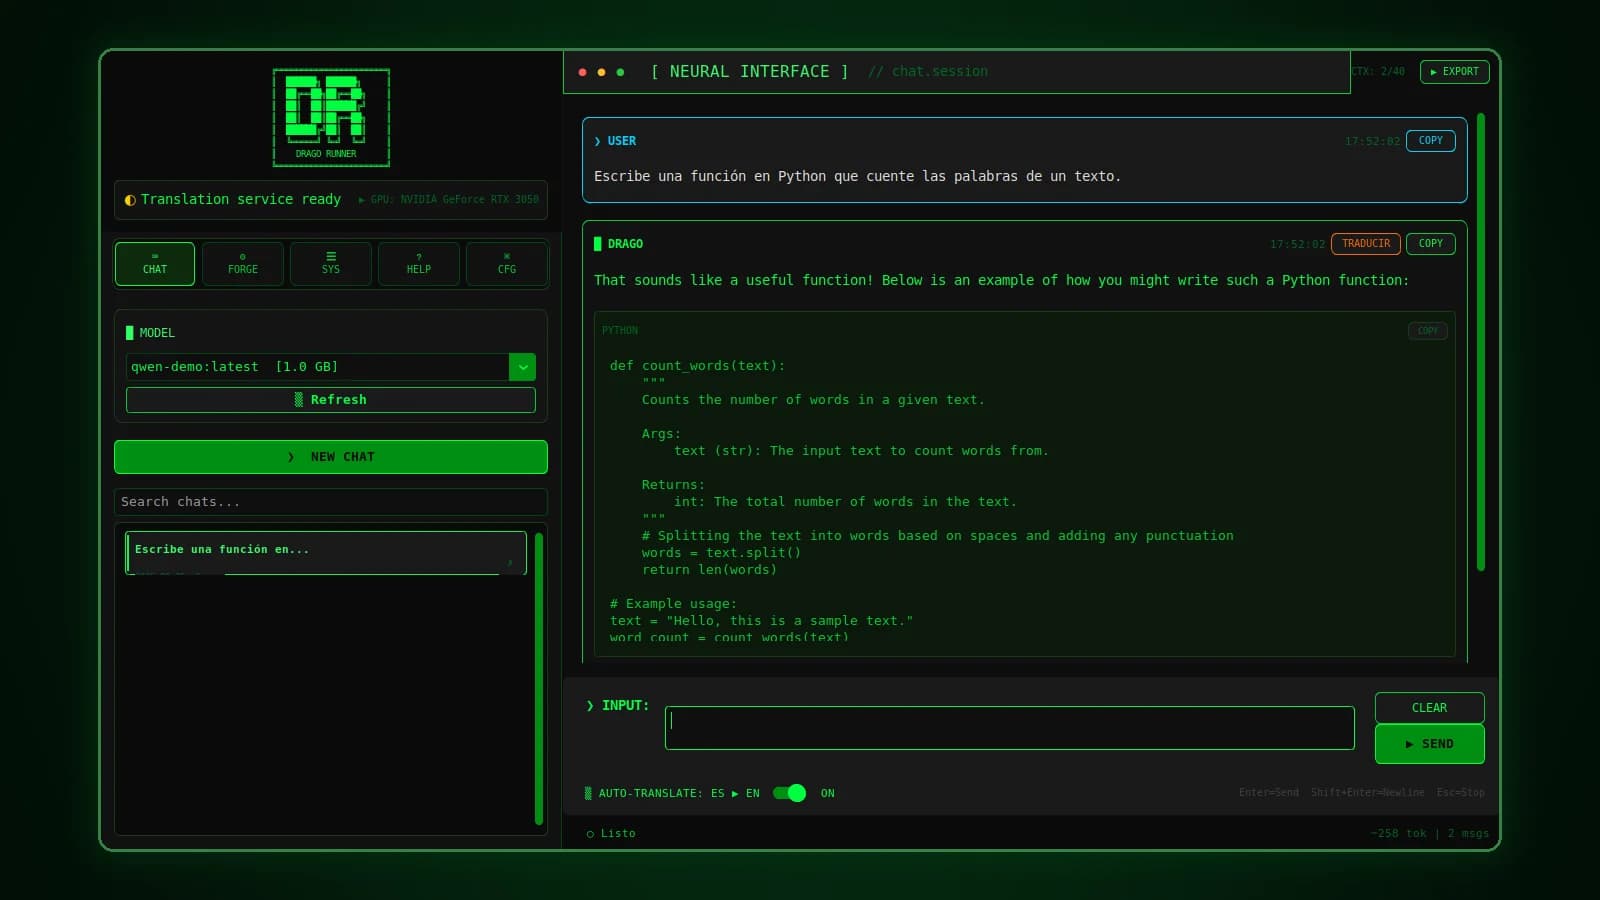
Las respuestas aparecen token a token, con Markdown, bloques de código con botón de copiar y Esc para cortar la generación.
Model Forge
Crea un modelo de Ollama desde un GGUF en cuatro pasos guiados: fichero, system prompt, parámetros y creación, con vista previa del Modelfile.
Traducción offline
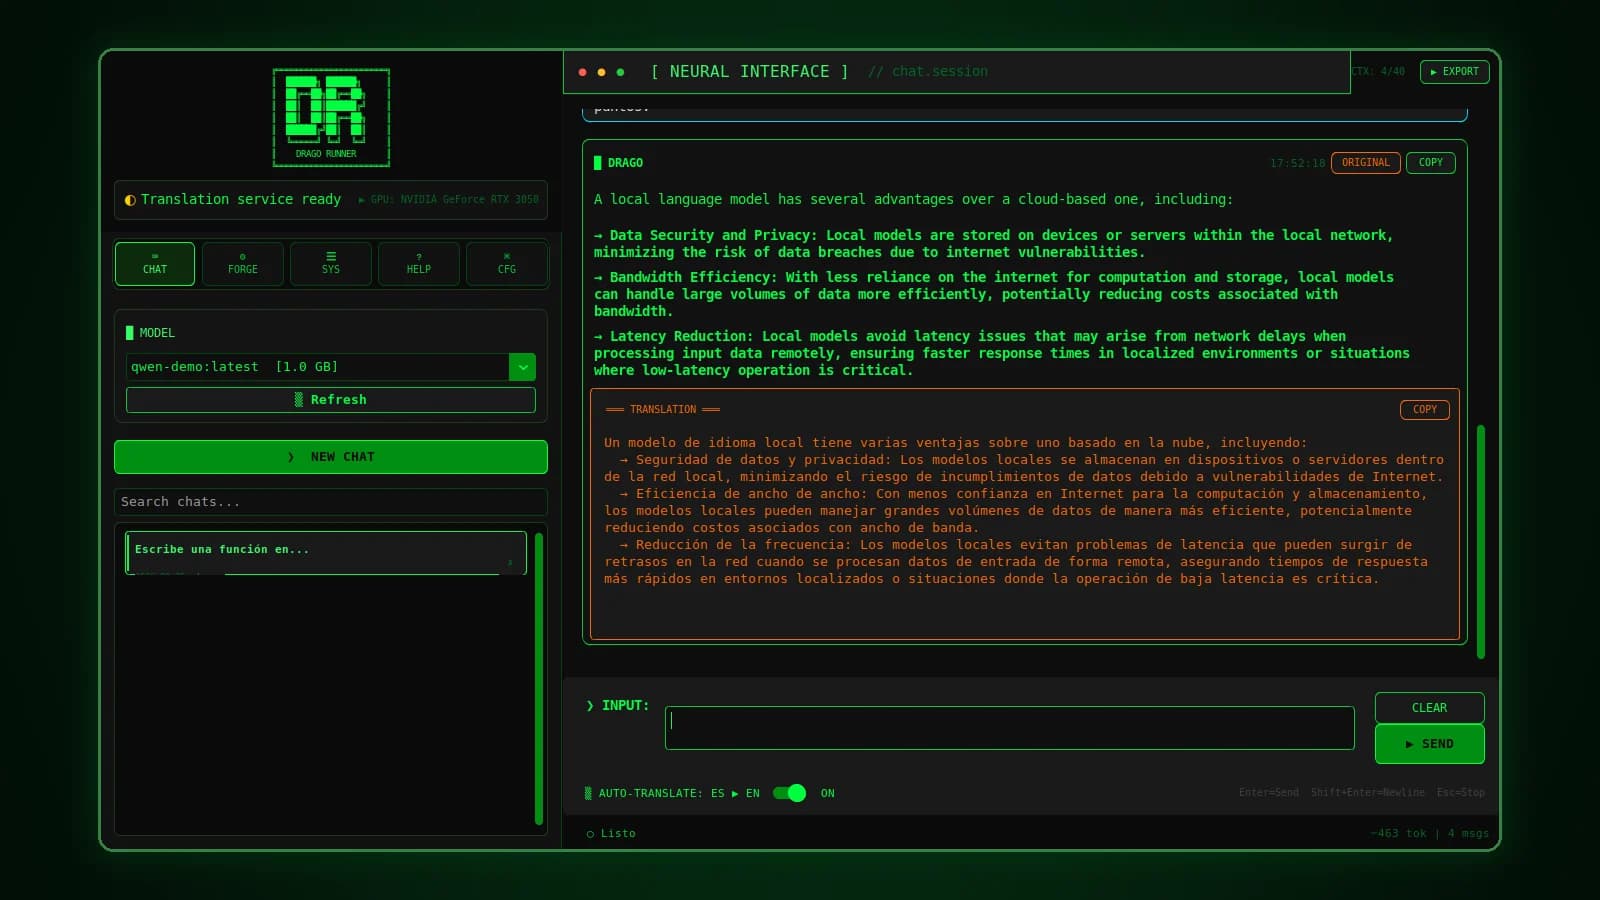
Argos Translate traduce tu mensaje ES→EN antes de enviarlo y cada respuesta tiene un botón TRADUCIR. Sin API keys.
Diagnóstico de hardware
Detecta GPU NVIDIA o AMD, lee CPU y RAM, refresca cada 30 s y estima si un modelo cabe en VRAM antes de cargarlo.
Historial de chats
Guardado automático en JSON, títulos a partir del primer mensaje, búsqueda por título y contenido y exportación a Markdown.
Atajos de teclado
Ctrl+N nuevo chat, Ctrl+L limpiar, Ctrl+E exportar y Ctrl+1 a Ctrl+5 para saltar entre los cinco paneles.
Cómo funciona por dentro
Cada mensaje se envía con el cliente oficial de Ollama en modo streaming desde un hilo aparte, que va entregando tokens a la interfaz. Un threading.Event permite cancelar a mitad de respuesta, y si el servidor de Ollama se cae en pleno stream el error llega al chat en lugar de colgar la ventana. Al modelo solo se le mandan los últimos 40 mensajes: una ventana deslizante con un contador CTX visible que se pone en amarillo al superarla.
Para crear modelos, la app escribe un Modelfile junto al GGUF y llama a ollama create -f como subproceso, leyendo su salida para mostrar el progreso. Lo hace así porque Ollama 0.15 retiró el parámetro modelfile de su API y la alternativa solo acepta nombres de modelo, no rutas a un fichero.
Model Forge y el monitor
Model Forge busca ficheros .gguf en ~/ai-models, ~/models y el almacén de Ollama, reconoce los modelos partidos (00001-of-00003) y extrae la cuantización del nombre (Q4_K_M, Q8_0, FP16…). Ofrece cuatro presets de parámetros (Balanced, Creative, Precise y Code, este último con 8.192 de contexto) y cinco perfiles de system prompt.
El panel de Sistema consulta nvidia-smi o, si no hay NVIDIA, rocm-smi. Con la VRAM libre y la RAM disponible estima cómo irá un modelo: si cabe entero en GPU con margen es «EXCELENTE»; si cabe al menos la mitad, avisa de que el resto irá a RAM y será más lento; si no hay memoria suficiente, lo dice antes de intentarlo.
Historia del proyecto
La primera versión funcional llegó el 5 de febrero de 2026: unas 3.400 líneas con el chat, Model Forge y, ese mismo día, el panel de Sistema. El 26 de febrero fue el gran salto, planificado con documentos de diseño en el propio repositorio: la capa de traducción con Argos, la persistencia y búsqueda de chats y una revisión completa de la interfaz con tokens de tema, navegación por pestañas y burbujas de chat nuevas. También se arregló el icono del dock en Ubuntu fijando el WM_CLASS de la ventana. El 2 y 3 de marzo cerré con correcciones y el README. Ollama desde el móvil está en DragoTerminal.
Límites conocidos
Necesita Ollama instalado: la app detecta si está y puede arrancar el servidor, pero no lo instala. El monitor de sistema lee /proc/cpuinfo y /proc/meminfo y el icono del dock está pensado para GNOME y KDE: está hecho sobre Linux. La traducción descarga una vez los paquetes de idioma de Argos; desde ahí funciona sin conexión.
Tecnologías
- Python 3.10+
- CustomTkinter
- Ollama (cliente Python)
- httpx
- Pydantic 2
- Argos Translate
- Pillow
- pyperclip
- nvidia-smi / rocm-smi
Publicaciones relacionadas
Aleph: un estudio de IA generativa 100 % local
Imagen, vídeo y voz en tu propio ordenador: sin nube, sin cuentas y sin dependencias.
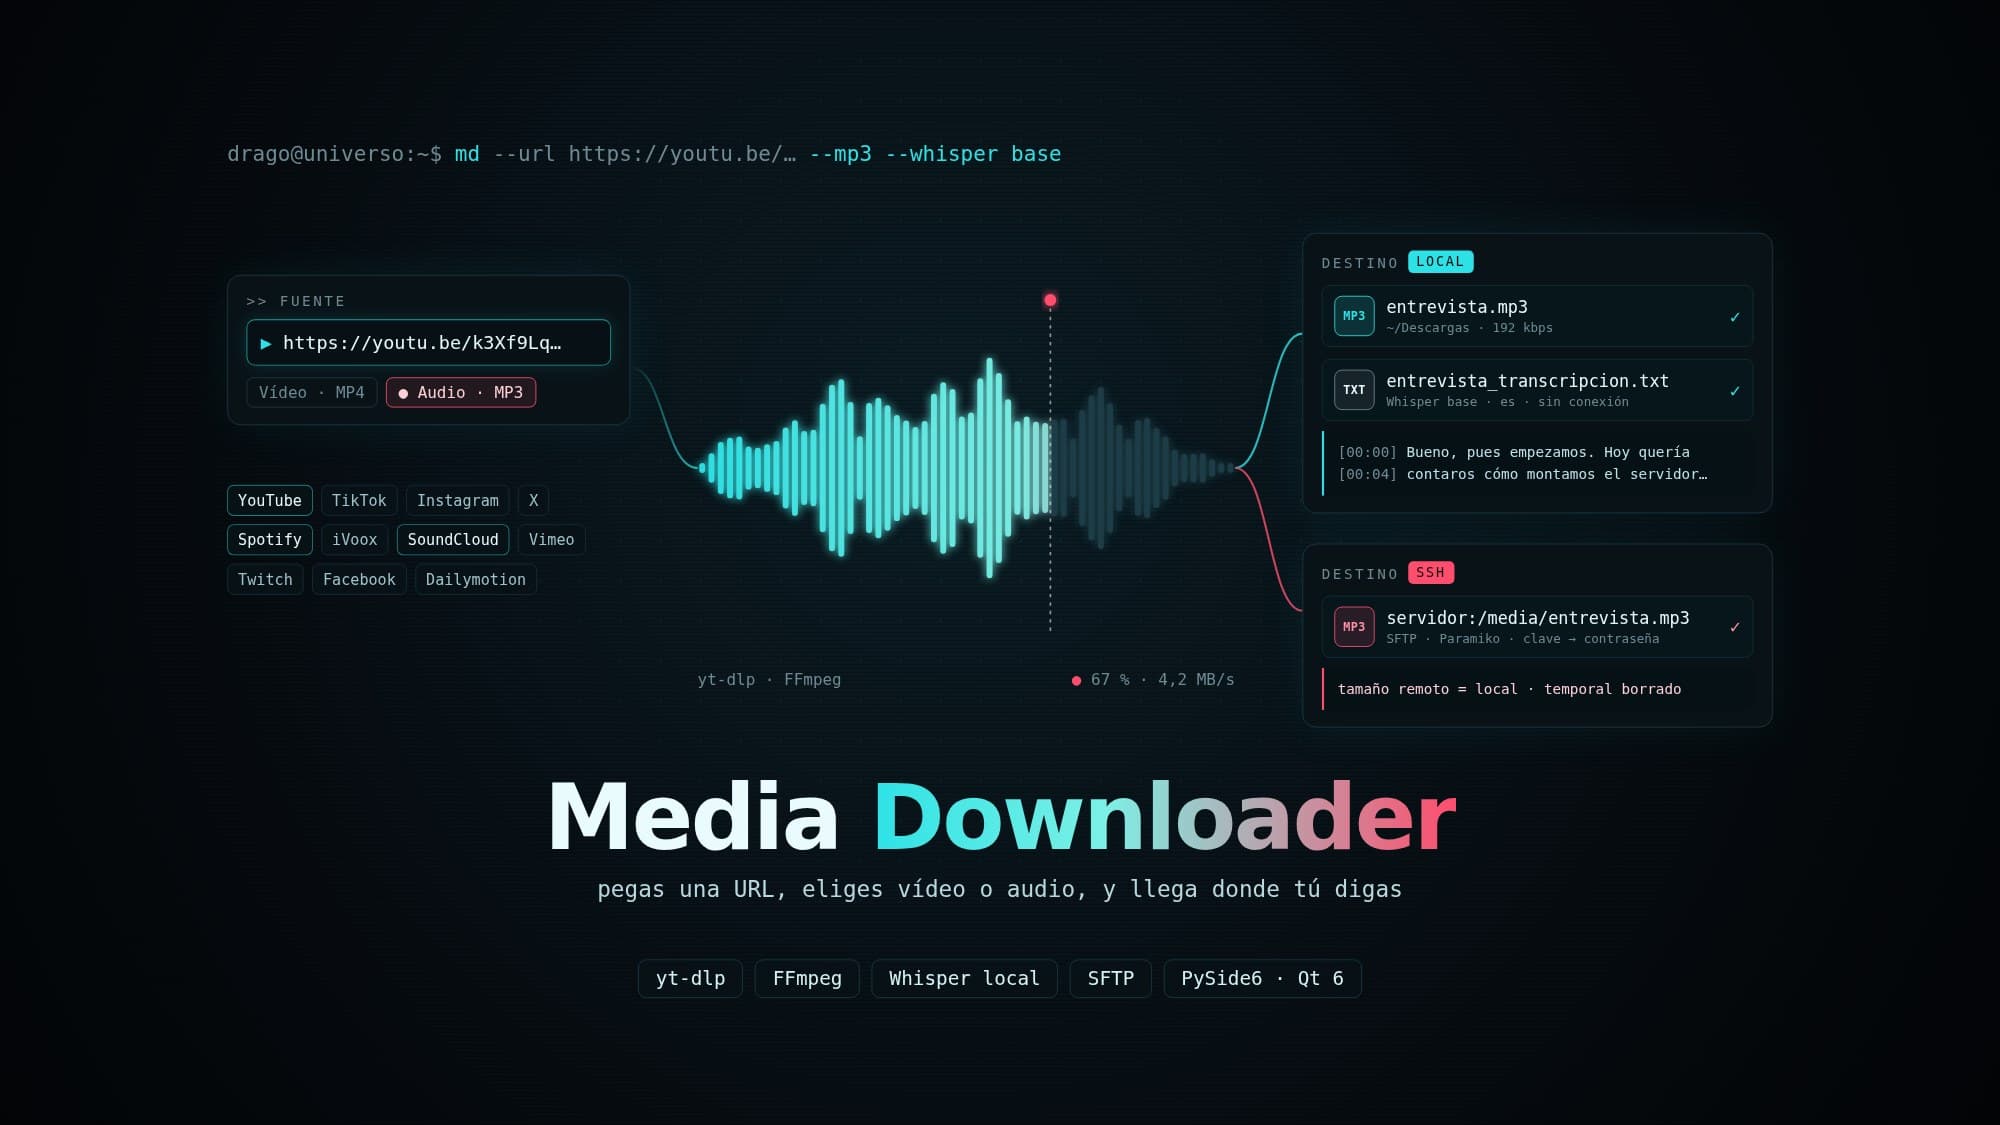
Media Downloader
Baja vídeo o audio de una docena de plataformas, lo transcribe con Whisper y lo sube por SFTP.
DragoTerminal: 34 herramientas y 59 juegos en una terminal Matrix
Navaja suiza Android: SSH, bases de datos, red, IA y un arcade de 59 juegos, estilo Matrix.
Comentarios
0 comentarios